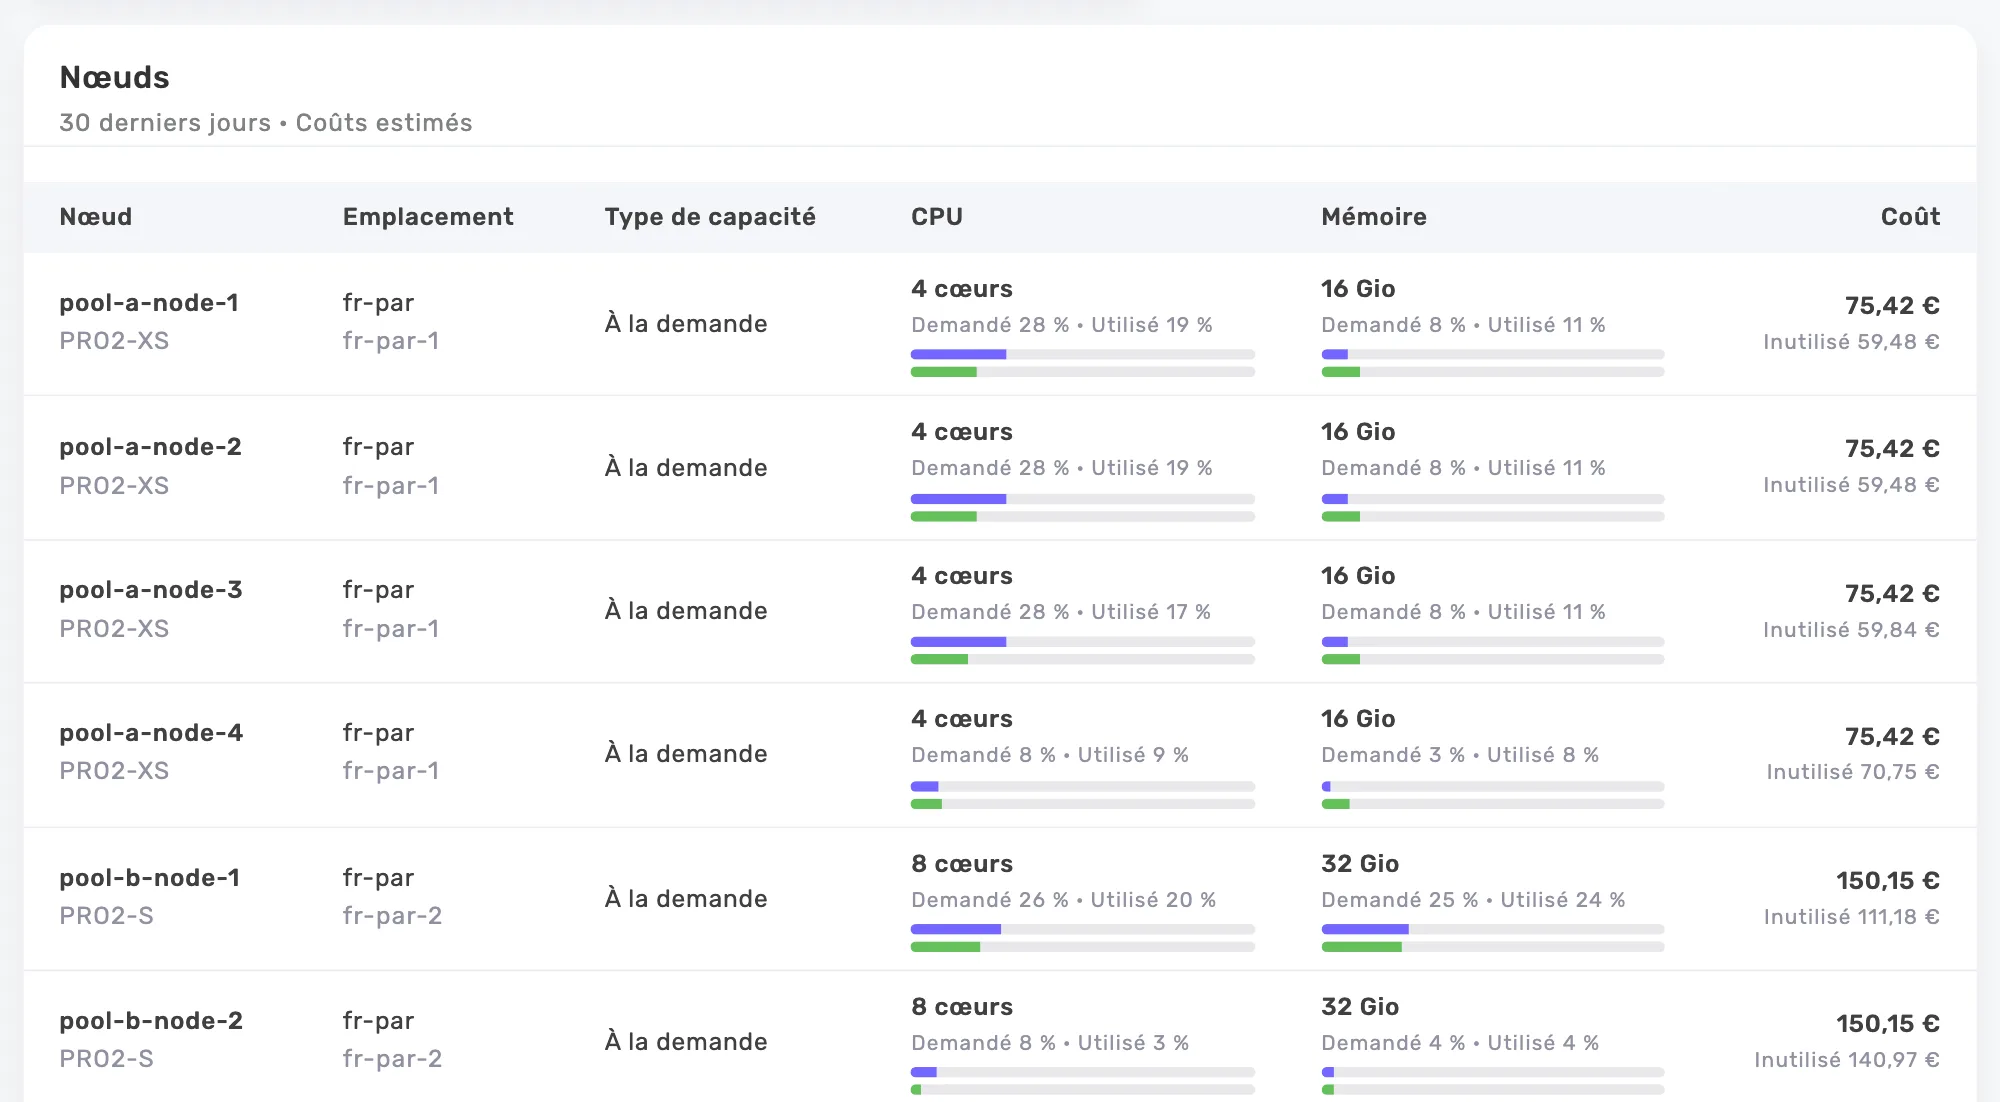
Il regarde d’abord
Chaque nouveau workload observe 7 jours avant son premier pas. L’auto-resize apprend son usage, puis calcule sa cible : les nouvelles requests, les cœurs et la mémoire à rendre, le montant par mois. Rien n’est touché avant. En Free, il s’en tient à cette simulation, workload par workload.
Vous choisissez où il agit
Le cluster donne son accord par une option du chart Helm, autoresize.enabled=true. L’auto-resize agit alors sur les Deployments et StatefulSets de tous les namespaces, sauf kube-system et les autres namespaces système, celui de l’agent et ceux que le chart exclut. Dans l’app, un switch par namespace et par workload, actif par défaut, le coupe, et les valeurs d’origine reviennent aussitôt. Il n’y a rien à régler : les marges suivent le type de service ; le pas, le canari et les échauffements sont fixes.
Il agit la nuit, par petits pas
Chaque nuit, il baisse la request d’un workload de 20 % au plus, une fois par 24 heures. Le CPU d’abord, la mémoire 48 heures après le dernier pas CPU sans alerte. Cible CPU : le percentile de la recommandation, le 95e par défaut, plus 15 %. Cible mémoire : le plus haut entre le pic plus 20 % et le pic projeté à 30 jours plus 10 %. Les pods en cours sont redimensionnés en place ; un webhook applique les mêmes valeurs aux pods recréés.
Il vérifie, et revient en arrière
Sur un workload de 2 pods ou plus, un canari de 30 minutes précède les autres pods. Une période d’échauffement de 10 minutes après le démarrage, 20 pour une JVM, évite de juger trop tôt. Au moindre OOM, redémarrage, throttling ou échec de sonde, les valeurs d’origine reviennent et le workload est gelé 7 jours.
Il connaît vos services
Il reconnaît les bases de données, les JVM, les caches, les séries temporelles comme Prometheus, les batchs et les GPU, et applique les marges de chacun. Les bases de données, les caches et tout service dont la mémoire grandit semaine après semaine gardent leur mémoire : seul leur CPU baisse. Les batchs et les GPU restent tels quels. L’annotation onicost.com/service-type force le type si besoin.
Ce qu’il ne fait jamais
Il ne touche pas aux limits, ne baisse jamais un pod Guaranteed et ne descend jamais sous la moitié de la valeur du gabarit. Il ne modifie pas votre dépôt Git : l’app donne le patch à reporter. Il ignore les DaemonSets, Jobs, CronJobs, pods nus, Rollouts Argo et pods d’opérateur, ainsi que les workloads qu’un HPA pilote sur le CPU ou la mémoire et ceux qu’un VPA suit.
Le journal et l’arrêt d’urgence
Chaque pas, chaque retour arrière et chaque workload ignoré est écrit dans le journal, avec sa raison. Couper le switch d’un workload ou d’un namespace remet aussitôt les valeurs d’origine. « Tout arrêter » fait de même pour toute l’organisation, nouveaux namespaces compris, jusqu’à « Reprendre ». En GitOps, l’annotation onicost.com/autoresize: ignore exclut un workload depuis votre dépôt.
Onicost ou le Vertical Pod Autoscaler ?
Le VPA du projet Kubernetes recalcule les requests et sait, dans ses dernières versions, les appliquer en place. C’est un bon outil. Onicost ajoute ce qui manque souvent pour oser l’activer en prod, critère par critère.
- Taille d’un changement. VPA : la recommandation entière, dans les bornes minAllowed et maxAllowed. Onicost : 20 % au plus par pas, un pas par nuit.
- Vérification après un changement. VPA : non. Onicost : un canari de 30 minutes et un échauffement.
- Après un OOM. VPA : il relève sa recommandation mémoire. Onicost : il remet les valeurs d’origine et gèle le workload 7 jours.
- Type de service et tendance. VPA : non. Onicost : oui, et jamais la mémoire d’un service qui grandit.
- Avant d’agir. VPA : le mode Off, avec les recommandations seules. Onicost : 7 jours d’observation par workload, et en Free une simulation chiffrée en euros.
- Coût. VPA : non. Onicost : l’économie par workload et la facture du cluster.
Prérequis
Kubernetes 1.35 ou plus sur l’API server et sur au moins un nœud (les pods des nœuds plus anciens sont ignorés), l’agent et le chart 0.8.0 ou plus, autoresize.enabled=true dans le chart et un plan Team ou Business ; l’essai Team agit partout, prod comprise. Avec Argo CD, le certificat du webhook généré par Helm change à chaque rendu : le README du chart donne le ignoreDifferences à ajouter.
Ce que montre chaque offre
Free : l’éligibilité de chaque cluster et la simulation, workload par workload, de ce que l’auto-resize rendrait. Team et Business : l’auto-resize qui agit, les switches, l’arrêt et le journal. L’essai Team agit aussi, prod comprise. Team à partir de 39 € HT par mois.
Questions fréquentes
L’auto-resize peut-il casser la prod ?
Il baisse les requests de 20 % au plus par pas et par nuit, vérifie chaque pas sur un canari et revient aux valeurs d’origine au moindre OOM ou throttling. Il ne touche ni aux limits ni aux pods Guaranteed. Un switch l’arrête par namespace ou par workload, et « Tout arrêter » coupe tout.
Mon cluster est en 1.32, que puis-je faire ?
Les recommandations fonctionnent déjà : elles chiffrent chaque request trop large et donnent les valeurs à appliquer à la main. L’auto-resize démarre après la montée en 1.35, avec l’agent 0.8.0 et l’option du chart.
Est-ce que ma facture baisse tout de suite ?
Des requests plus basses libèrent de la place sur les nœuds. La facture baisse quand l’autoscaler, Karpenter ou Cluster Autoscaler, retire les nœuds en trop. Onicost montre les deux : la capacité libérée et le coût du cluster.
Et avec Argo CD ou Flux ?
L’auto-resize ne modifie pas votre dépôt. Le webhook applique les nouvelles valeurs aux pods au moment de leur création, et l’app donne le patch à reporter dans le gabarit quand vous le souhaitez. L’annotation onicost.com/autoresize: ignore exclut un workload depuis le dépôt.
Quels droits demande-t-il ?
Le droit de redimensionner les pods (pods/resize) et un webhook d’admission, jamais appelé dans les namespaces système, celui de l’agent ou ceux que le chart exclut. Sans autoresize.enabled=true dans le chart, il ne fait rien.
Comment l’arrêter ?
Le switch d’un namespace ou d’un workload dans l’app, qui remet aussitôt les valeurs d’origine, « Tout arrêter » pour toute l’organisation, l’annotation onicost.com/autoresize: ignore sur un workload, ou autoresize.enabled=false dans le chart.