Ce que font les deux outils
La documentation Kubernetes parle de provisionnement et de consolidation. Le provisionnement ajoute des nœuds quand des pods ne trouvent pas de place. La consolidation retire les nœuds sous-utilisés et peut en créer d’autres pour les remplacer. Vous croiserez encore les anciens termes scale-up et scale-down.
Les deux projets sont portés par le SIG Autoscaling. Kubernetes les décrit comme proches à l’usage et renvoie le choix à votre cas. Point commun décisif pour le budget : ils raisonnent sur les requests des pods et ignorent l’usage réel. Une request trop haute garde donc un nœud allumé, quel que soit l’outil. Revoyez vos requests en premier.
Cluster Autoscaler : vous définissez les groupes de nœuds
Cluster Autoscaler ajoute ou retire des nœuds dans des groupes configurés à l’avance. Dans un groupe, toutes les machines ont la même capacité et les mêmes labels. Toutes les 10 secondes par défaut, l’outil cherche des pods sans place et choisit un groupe. L’expander par défaut, least-waste, retient celui qui laisse le moins de CPU inoccupé après l’ajout.
Son atout est sa portée : il s’intègre à de nombreux fournisseurs, y compris de petits acteurs, au sein du projet Kubernetes. Sa limite tient aux groupes eux-mêmes. Chaque nouvelle forme de machine ou chaque mélange avec du Spot demande un groupe de plus à créer et à maintenir.
Pour retirer un nœud, il compare les requests CPU et mémoire à la capacité allouable. Sous 50 % par défaut, et après 10 minutes sans utilité, le nœud peut partir. Plusieurs cas bloquent cette étape :
- Un PodDisruptionBudget trop restrictif.
- Un pod qu’aucun contrôleur ne gère.
- Un pod avec du stockage local, sauf si une annotation liste ses volumes locaux.
- Un pod annoté cluster-autoscaler.kubernetes.io/safe-to-evict: false.
Karpenter : vous définissez les contraintes
Karpenter part des pods en attente et crée des machines individuelles pour eux. Il se passe de groupes préparés. Vous posez vos contraintes dans un NodePool, par exemple les types d’instance permis ou la capacité Spot, et une NodeClass propre au fournisseur, comme EC2NodeClass sur AWS, porte les réglages cloud. En novembre 2026, sa documentation donnait la version 1.15 comme dernière version.
Son périmètre est plus large : il gère tout le cycle de vie des nœuds. Le champ consolidationPolicy règle son degré d’initiative. WhenEmpty retire seulement les nœuds vides. Balanced agit quand l’économie justifie la perturbation. WhenEmptyOrUnderutilized, la valeur par défaut, examine tout nœud qu’il peut retirer ou remplacer. Les nœuds expirent aussi après 720 heures par défaut, et Karpenter remplace ceux qui s’écartent de leur NodePool.
Cette liberté a ses limites :
- Moins de fournisseurs l’intègrent. La documentation Kubernetes cite AWS et Azure parmi eux.
- Les nœuds changent en général plus souvent, donc les pods redémarrent plus souvent. Posez des PodDisruptionBudgets sur vos workloads.
- Par défaut, le budget de perturbation d’un NodePool plafonne les retraits volontaires à 10 % des nœuds. Il ne limite ni l’expiration ni l’interruption.
- Sur AWS, la gestion des interruptions demande une file SQS et des règles EventBridge.
Passer de Cluster Autoscaler à Karpenter
Le guide de migration de Karpenter vise EKS et suppose des PodDisruptionBudgets en place. Ses étapes aident aussi à préparer un passage ailleurs.
- Conservez un petit groupe de nœuds statique. Le contrôleur Karpenter y tourne, hors des nœuds qu’il gère.
- Envisagez d’y épingler les modules critiques comme CoreDNS et metrics-server.
- Créez un NodePool et une NodeClass, puis passez Cluster Autoscaler à zéro réplica.
- Réduisez les groupes, quelques instances à la fois sur un gros cluster. Sans PodDisruptionBudget, des workloads peuvent devenir indisponibles.
Ce qu’apporte Onicost : mesurer l’effet
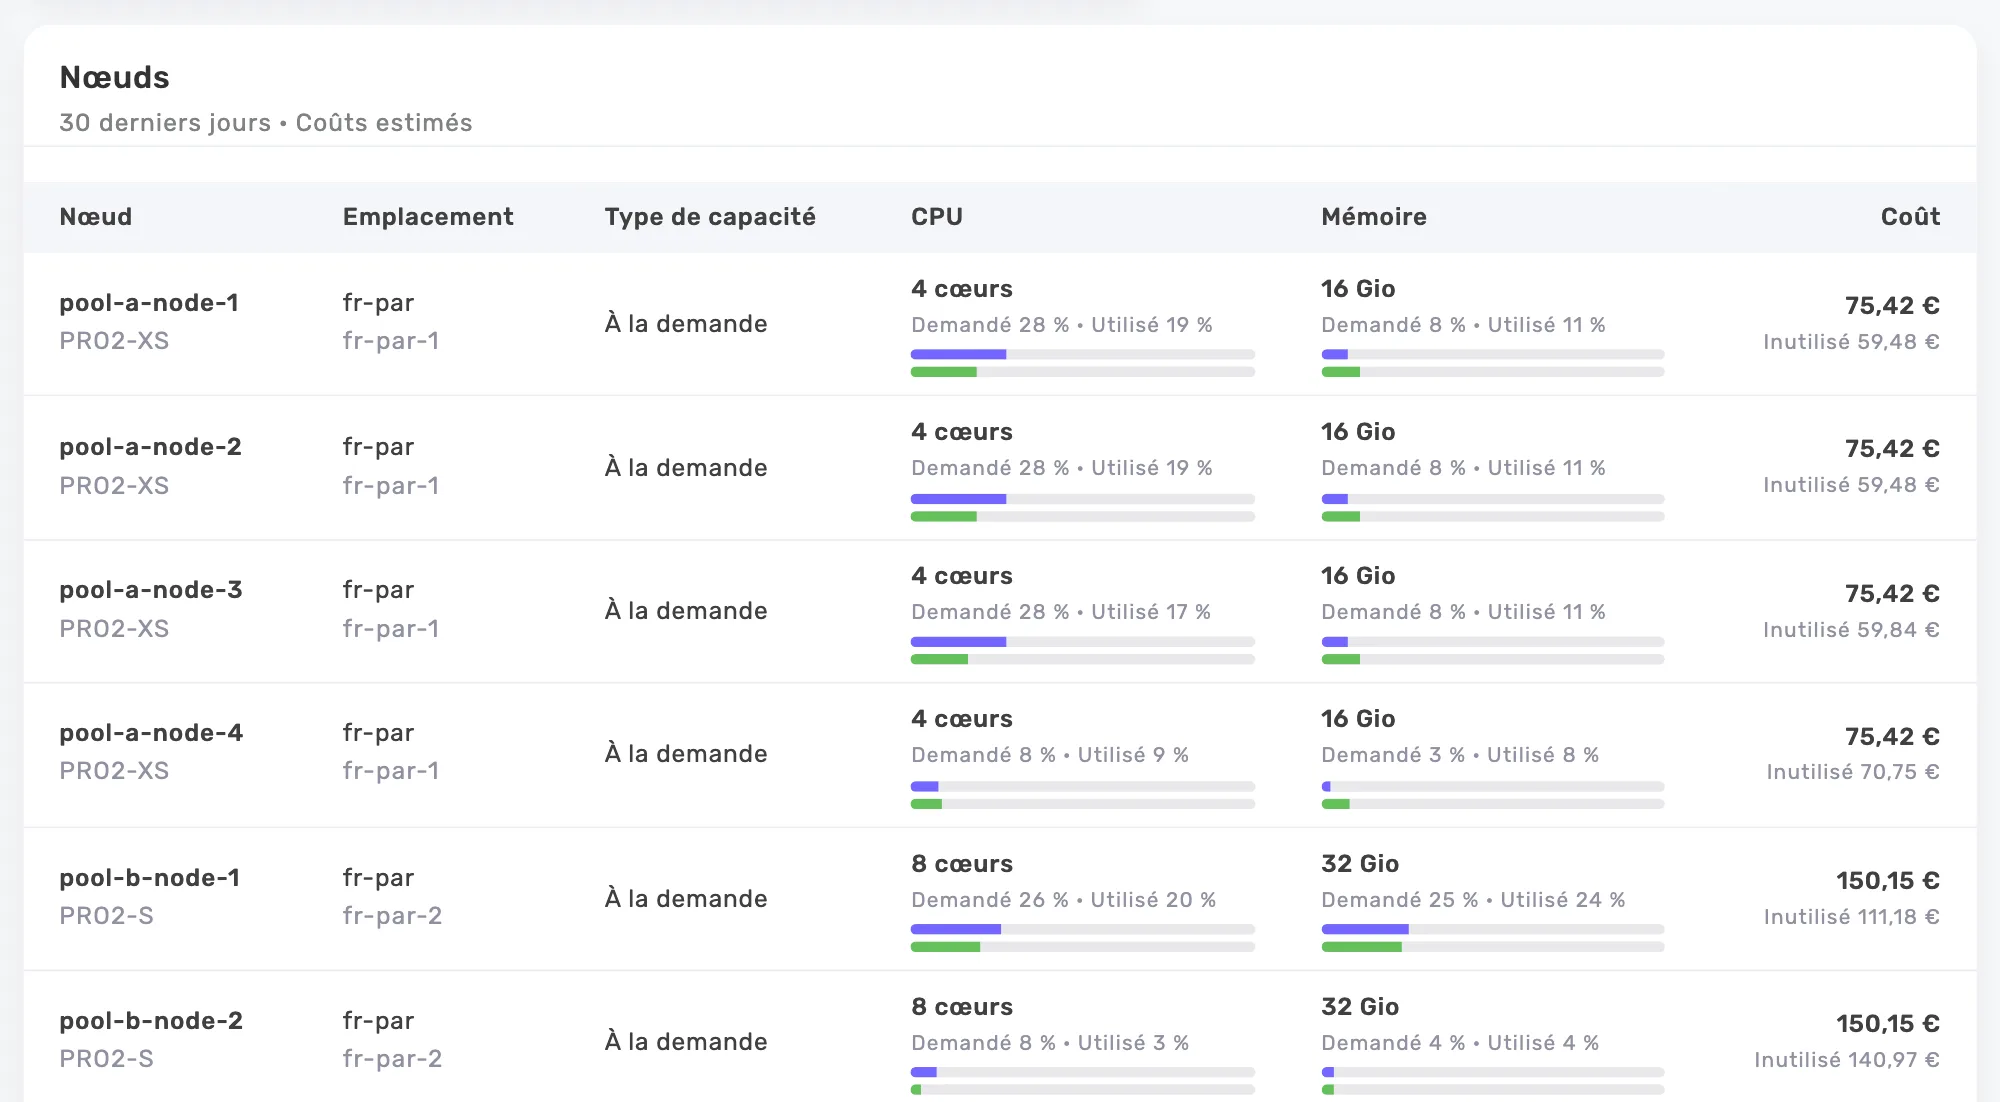
Onicost montre le coût par nœud, workload et namespace, à côté des requests et de l’usage réel. Il regroupe les nœuds par pool, dont les NodePools Karpenter, les node groups EKS et les pools GKE, AKS, Kapsule et OVHcloud. Comparez les semaines avant et après le changement. Ces coûts sont des estimations fondées sur les prix publics et vos réglages.
Les recommandations signalent les requests trop hautes, les pools à réduire et les workloads qui pourraient passer en Spot, avec une économie mensuelle estimée quand elle est chiffrable. Aucune économie n’est garantie, et votre équipe applique les changements. Le scheduler d’Onicost peut arrêter des workloads, mais les nœuds libérés ne s’éteignent que si le cluster a un autoscaler.
Free couvre 1 cluster, 32 cœurs et 2 membres. Les recommandations détaillées viennent avec Team, dès 39 € HT par mois, avec un essai de 14 jours sans carte.
Questions fréquentes
Faut-il retirer Cluster Autoscaler pour utiliser Karpenter ?
Le guide de migration de Karpenter le désactive en le passant à zéro réplica une fois Karpenter en place. Un petit groupe de nœuds statique reste pour le contrôleur et les modules critiques.
Changer d’outil va-t-il baisser ma facture ?
C’est possible, sans garantie. Les deux outils décident à partir des requests : des requests trop hautes continuent de coûter. Mesurez avant et après le changement.
Comment choisir
Partez de votre fournisseur, puis regardez comment vos workloads varient. Aucun autoscaler ne garantit une facture plus basse : des budgets stricts, de gros pods ou des contraintes de zone peuvent garder la plupart des nœuds en place. Testez sur un cluster hors production et mesurez le temps d’attente, les redémarrages de pods et le coût estimé avant de trancher.